دا طریقه د AI سره مرسته کوي ترڅو پوه شي چې کله د ځانګړو پوښتنو څخه مخنیوی وشي. دا زده کوي چې غوښتنې رد کړي چې زیان رسونکي مواد لکه تاوتریخوالی یا تبعیض پکې شامل وي.
د RLHF کارولو ماډل یوه مشهوره بیلګه د OpenAI ChatGPT ده . دا ماډل د ځوابونو ښه کولو او دوی ډیر اړونده او مسؤل کولو لپاره د انسانانو فیډبیک کاروي.
د انساني فیډبیک سره د پیاوړتیا زده کړې مرحلې
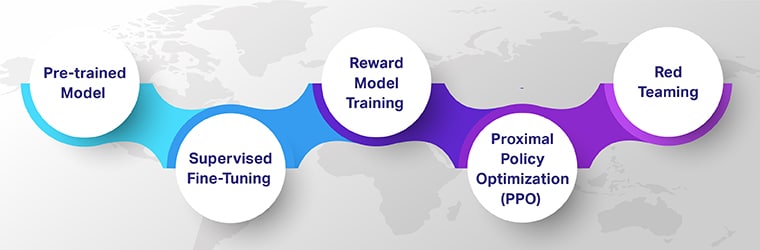
د انساني فیډبیک سره د پیاوړتیا زده کړه (RLHF) ډاډ ترلاسه کوي چې د AI ماډلونه له تخنیکي پلوه مهارت لري، له اخلاقي پلوه سالم، او په شرایطو پورې اړوند دي. د RLHF پنځه کلیدي مرحلو ته وګورئ چې دا وپلټئ چې دوی څنګه د پرمختللو، د انسان لارښود AI سیسټمونو رامینځته کولو کې مرسته کوي.
د مخکې روزل شوي ماډل سره پیل کول
د RLHF سفر د مخکې روزل شوي ماډل سره پیل کیږي، د انسان په لاس کې د ماشین زده کړې یو بنسټیز ګام. په پیل کې په پراخه ډیټاسیټونو کې روزل شوي، دا ماډلونه د ژبې یا نورو بنسټیزو کارونو پراخه پوهه لري مګر تخصص نلري.
پراختیا کونکي د مخکې روزل شوي ماډل سره پیل کوي او د پام وړ ګټه ترلاسه کوي. دا ماډلونه دمخه د ډیرو معلوماتو څخه زده شوي دي. دا د دوی سره د روزنې په لومړني مرحله کې د وخت او سرچینو خوندي کولو کې مرسته کوي. دا مرحله د ډیر متمرکز او ځانګړي روزنې لپاره مرحله ټاکي چې تعقیب کیږي.
څارل شوی ښه ټیوننګ
په دویمه مرحله کې د نظارت شوي ښه ټیوننګ شامل دي، چیرې چې مخکې روزل شوي ماډل په یوه ځانګړي دنده یا ډومین کې اضافي روزنه ترلاسه کوي. دا مرحله د لیبل شوي ډیټا په کارولو سره مشخص کیږي ، کوم چې د ماډل سره مرسته کوي ډیر دقیق او په شرایطو پورې اړوند محصول تولید کړي.
دا د ښه تنظیم کولو پروسه د انسان لارښود AI روزنې یوه غوره بیلګه ده ، چیرې چې انساني قضاوت د مطلوب چلند او ځوابونو په لور د AI په رهبري کولو کې مهم رول لوبوي. روزونکي باید په دقت سره د ډومین ځانګړي ډیټا غوره او وړاندې کړي ترڅو ډاډ ترلاسه شي چې AI په لاس کې د دندې باریکیو او ځانګړو اړتیاو سره تطابق کوي.
د انعام ماډل روزنه
په دریم ګام کې، تاسو یو جلا ماډل روزئ ترڅو د مطلوب محصول پیژندلو او انعام ورکولو لپاره چې AI تولیدوي. دا ګام د فیډبیک پراساس AI زده کړې لپاره مرکزي دی.
د انعام ماډل د AI محصول ارزونه کوي. دا د معیارونو پراساس نمرې ګماري لکه اړونده ، دقت او د مطلوب پایلو سره سمون. دا نمرې د فیډبیک په توګه عمل کوي او د لوړ کیفیت ځوابونو تولید لپاره AI ته لارښود کوي. دا پروسه د پیچلو یا موضوعي دندو په اړه خورا دقیق پوهه رامینځته کوي چیرې چې روښانه لارښوونې ممکن د اغیزمنې روزنې لپاره کافي نه وي.
د نږدې پالیسۍ اصلاح کولو (PPO) له لارې پیاوړتیا زده کړه
بیا، AI د پروکسیمل پالیسي اصلاح (PPO) له لارې د پیاوړتیا زده کړې څخه تیریږي، د متقابل ماشین زده کړې کې یو پیچلي الګوریتمیک طریقه.
PPO AI ته اجازه ورکوي چې د خپل چاپیریال سره د مستقیم تعامل څخه زده کړي. دا د تصمیم نیولو پروسه د انعامونو او جریمو له لارې اصالح کوي. دا میتود په ځانګړي ډول د ریښتیني وخت زده کړې او موافقت کې مؤثره دی ، ځکه چې دا د AI سره مرسته کوي چې په مختلف سناریوګانو کې د دې عملونو پایلو پوه شي.
PPO د AI په تدریس کې مهم دی چې پیچلي، متحرک چاپیریال ته حرکت وکړي چیرې چې مطلوب پایلې ممکن وده وکړي یا تعریف کول ستونزمن وي.
سور ټیمینګ
وروستی ګام د مصنوعي ذهانت سیسټم سخت ریښتیني نړۍ ازموینه ده. دلته، د ارزونکو یوه متنوع ډله، چې د " سور ټیم " په نوم پیژندل کیږي، د مختلفو سناریوګانو سره مصنوعي ذهانت ننګوي. دوی د دې وړتیا ازمويي چې په سمه او مناسبه توګه ځواب ووایی. دا مرحله ډاډ ورکوي چې مصنوعي ذهانت کولی شي د حقیقي نړۍ غوښتنلیکونه او غیر متوقع حالتونه اداره کړي.
ریډ ټیمینګ د AI تخنیکي وړتیا او اخلاقي او متناسب سالمیت ازموي. دوی ډاډ ورکوي چې دا د منلو وړ اخلاقي او کلتوري حدودو کې کار کوي.
د دې ګامونو په اوږدو کې، RLHF د AI پراختیا په هر پړاو کې د انسان د ښکیلتیا په اهمیت ټینګار کوي. د لومړني روزنې لارښود کولو څخه په احتیاط سره ترتیب شوي ډیټا سره د دقیق فیډبیک او سخت ریښتیني نړۍ ازموینې چمتو کولو پورې ، د انسان انډول د AI سیسټمونو رامینځته کولو لپاره لازمي دی چې هوښیار ، مسؤل ، او د انساني ارزښتونو او اخلاقو سره مطابقت لري.
پایله
د انساني فیډبیک سره د پیاوړتیا زده کړه (RLHF) په AI کې یو نوی دوره ښیي ځکه چې دا د ډیر اخلاقي، دقیق AI سیسټمونو لپاره د ماشین زده کړې سره د انسان بصیرت ترکیب کوي.
RLHF ژمنه کوي چې AI به ډیر احساساتي، ټول شموله او نوښتګر کړي. دا کولی شي تعصبونه حل کړي او د ستونزې حل کولو ته وده ورکړي. دا د روغتیا پاملرنې ، تعلیم او پیرودونکو خدماتو په څیر ساحو بدلولو لپاره ټاکل شوی.
په هرصورت، د دې کړنالرې اصالح کول دوامداره هڅو ته اړتیا لري ترڅو اغیزمنتوب، عادلانه، او اخلاقي سمون ډاډمن کړي.