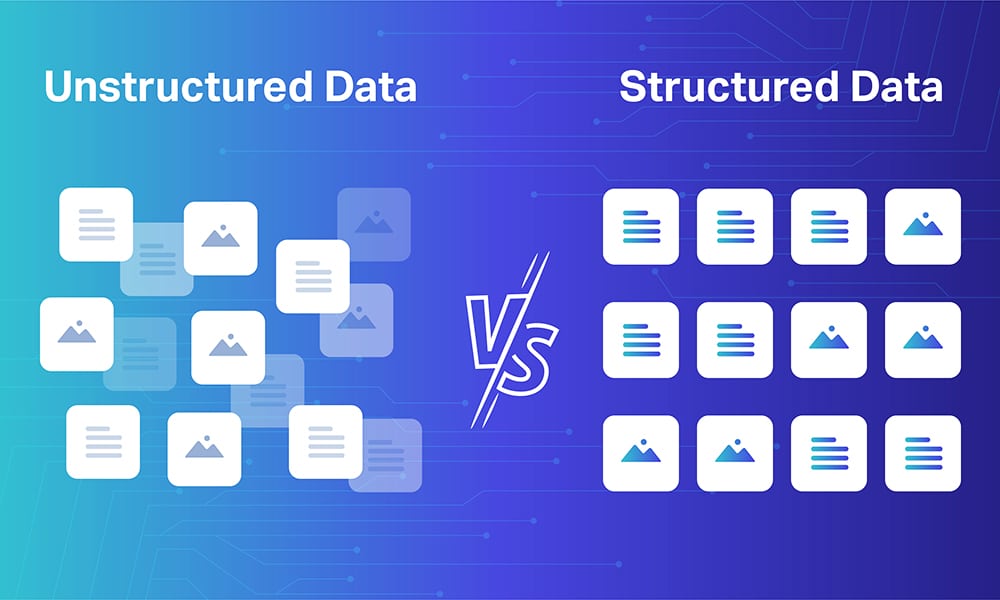

د تصدۍ مصنوعي ذهانت په زړه کې یو خاموش طنز شتون لري: په نړۍ کې تر ټولو هوښیار ماډلونه ستاسو سره مرسته نشي کولی که ستاسو معلومات په سکین شوي رسید، فکس شوي لابراتوار راپور، یا په لاس لیکل شوي تحویلي یادښت کې بند پاتې وي. او اټکل کیږي چې د سوداګرۍ 80٪ معلومات په دې ډول غیر منظم اسنادو کې ژوند کوي.
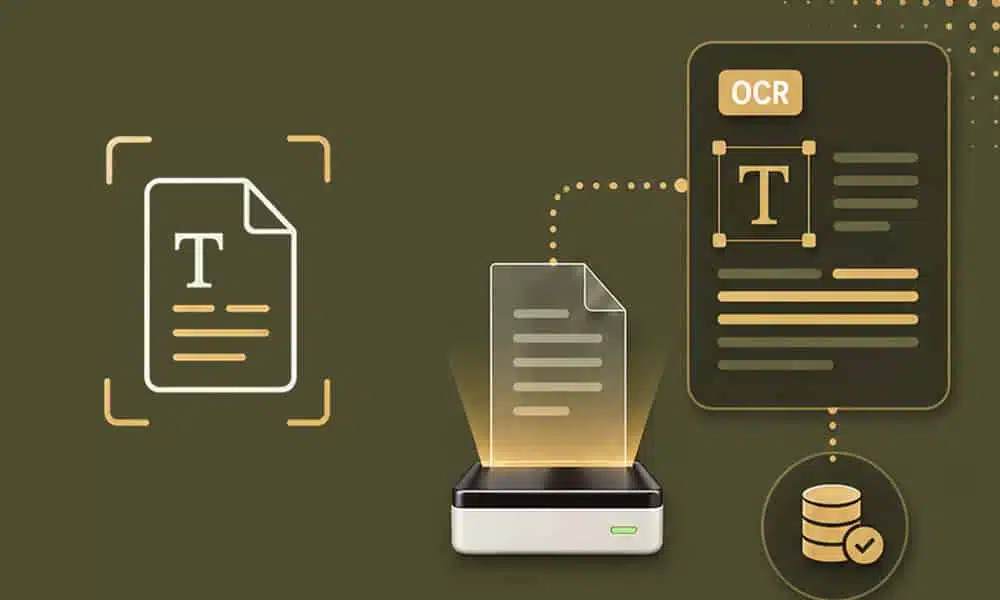
د نظري کرکټر پیژندنه - OCR - هغه ټیکنالوژي ده چې دا معلومات وړیا کوي. او په 2026 کې، دا یو شیبه لري. د OCR نړیوال بازار اټکل کیږي چې تر 2033 پورې 55.3 ملیارد ډالرو ته ورسیږي، چې په 2023 کې د 13.1 ملیارد ډالرو څخه لوړ دی، چې په کال کې 15.5٪ وده کوي. عصري انجنونه په منظم ډول د پاڼې په کچه 98-99٪ دقت ته رسیږي. هغه څه چې یو وخت د سکین کولو یو پیچلی اسانتیا وه اوس د تصدۍ اتومات کولو لپاره مخکینۍ دروازه ګرځیدلې ده.
دلته هغه څه دي چې نن ورځ OCR ښکاري: دا څنګه کار کوي، هغه ډولونه چې شتون لري، AI څه بدل شوی، او چیرته روان دی.
OCR څه شی دی؟
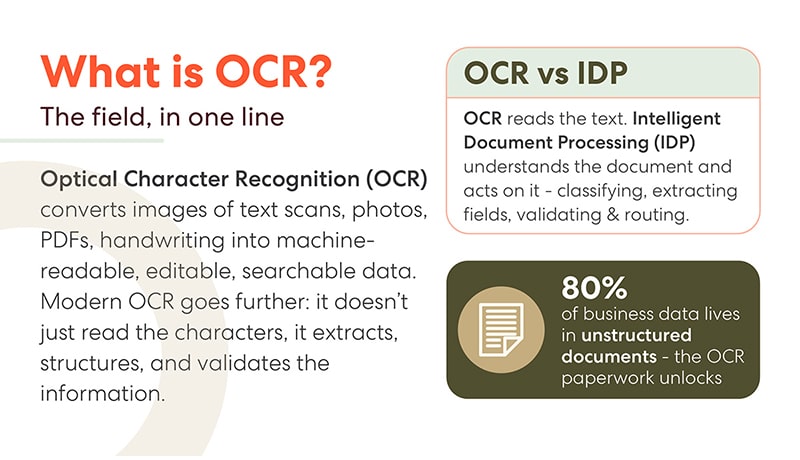
د نظري کرکټر پیژندنه د متن انځورونه - سکینونه، عکسونه، PDFs، لاس لیکل - د ماشین لوستلو وړ، د سمون وړ، د لټون وړ معلوماتو ته بدلوي. دا د درسي کتاب تعریف دی، او دا هغه څه کموي چې په 2026 کې په حقیقت کې پیښیږي.
عصري OCR یوازې حروف نه لولي. دا جوړښتونه - ساحې، جدولونه، لاین توکي - استخراجوي او هغه معلومات تاییدوي چې دا یې راوباسي. په تلیفون کې عکس اخیستل شوی یو ټوټه شوی انوائس ورته ورکړئ، او دا د متن یوه ټوټه نه بلکې یو جوړښتي ریکارډ بیرته راولي: پلورونکی، نیټه، لاین توکي، ټولټال، هر یو د باور نمرې سره.
د OCR او IDP ترمنځ توپیر: یو مهم توپیر
تاسو به د هر پلورونکي په خبرو اترو کې دواړه اصطلاحات واورئ، نو دلته توپیر دی. OCR متن لولي. هوښیار سند پروسس کول (IDP) سند پوهیږي او په هغې عمل کوي - طبقه بندي کول چې دا څه ډول سند دی، هغه ساحې استخراجوي چې مهم دي، د سوداګرۍ قواعدو په وړاندې یې تاییدوي، او پایله سم سیسټم ته لیږدوي.
د OCR په اړه د سترګو او د IDP په اړه د دماغ په اړه فکر وکړئ. یو له بل پرته تاسو یوازې نیمایي ته رسوي: په بشپړ ډول لیکل شوی متن چې لاهم د تفسیر لپاره انسان ته اړتیا لري، یا یو هوښیار کاري فلو چې د لوستلو وړ معلوماتو څخه محروم دی. بازار په قاطع ډول د ترکیب په لور روان دی.
OCR څنګه کار کوي: عصري شپږ مرحلې پایپ لاین
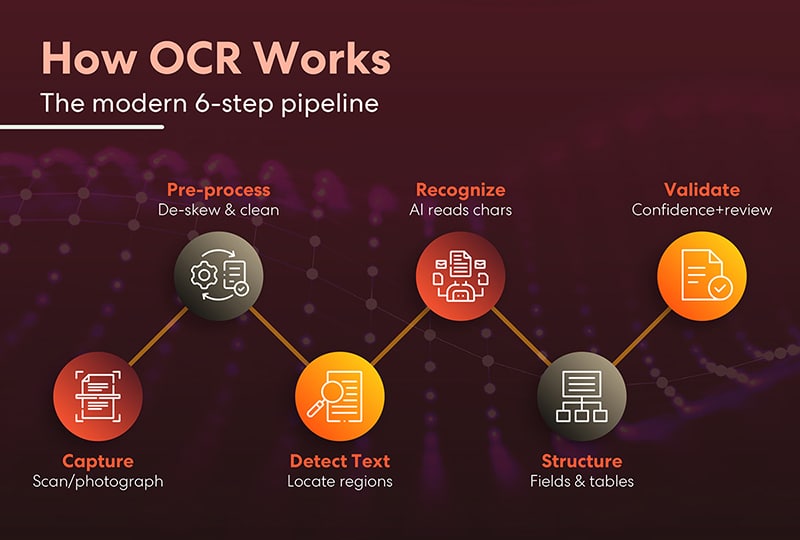
د نن ورځې د OCR سیسټمونه د شپږ مرحلو پایپ لاین تعقیبوي، او د دې پوهیدل د دې تشریح کولو کې مرسته کوي چې ولې دقت لوړ شوی او چیرته چې غلطۍ لاهم رامینځته کیږي.
دا د نیولو سره پیل کیږي — د سند سکین یا عکس. بیا مخکې له مخکې پروسس کول انځور پاکوي: د خم شوي پاڼو څخه لرې کول، شور لرې کول، او برعکس سمول، ځکه چې د پیژندنې کیفیت یوازې د هغه انځور په څیر ښه دی چې له هغه څخه پیل کیږي. بیا، د متن کشف د پاڼې هغه سیمې په ګوته کوي چې په حقیقت کې متن لري، کلمې د لوګو، سټمپونو او شالید څخه جلا کوي. بیا پیژندنه راځي ، چیرې چې AI حروف لولي — هغه ګام چې ډیری خلک یې د "OCR" په توګه فکر کوي. مګر عصري پایپ لاین هلته نه دریږي. جوړښت خام متن په ساحو او جدولونو کې نقشه کوي، "په پاڼه کې کلمې" په "په سکیما کې ډاټا" بدلوي. په پای کې، اعتبار د باور نمرې او بیاکتنې پلي کوي، مخکې لدې چې ستاسو سیسټمونو ته ننوځي د انسان لپاره هر څه ناڅرګنده نښه کوي.
نیول → مخکې له مخکې پروسس → کشف → پیژندنه → جوړښت → تایید کول. وروستي دوه مرحلې هغه څه دي چې د 2026 دورې OCR د یوې لسیزې دمخه د سکین کولو سافټویر څخه جلا کوي.
د OCR ډولونه: ټولې پیژندنې یو شان نه دي
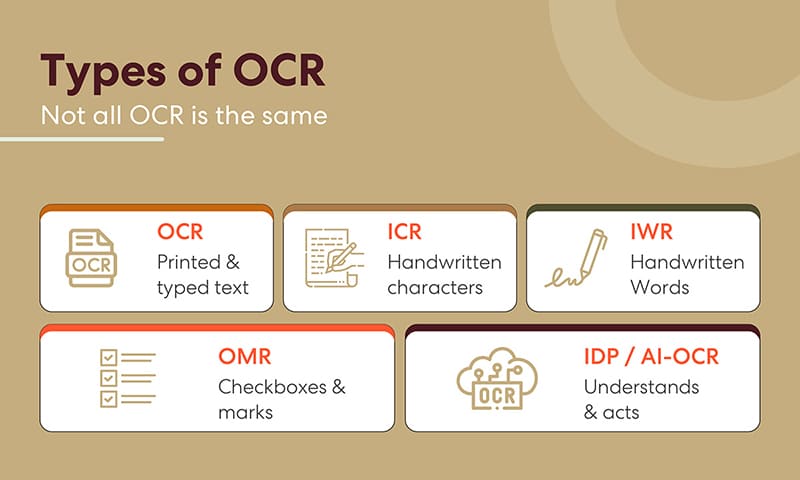
"OCR" د یوې عمومي اصطلاح په توګه کارول کیږي، مګر دا ساحه ډیری ټیکنالوژي توپیر کوي، چې هر یو یې د مختلف مینځپانګې لپاره مناسب دی.
د OCR سمه اداره چاپ شوي او ټایپ شوي متن - ترټولو اسانه قضیه او خورا بالغ. ICR (د هوښیار کرکټر پیژندنه) د لاس لیکل شوي حروف لوستل، چې په ساحه کې یو له سختو ستونزو څخه دی. IWR (د هوښیار کلمو پیژندنه) یو ګام نور هم ځي، د انفرادي لیکونو پرځای ټول لاس لیکل شوي کلمې پیژني - د کرسیو لپاره غوره مناسب دی، چیرې چې حروف یوځای تیاره کیږي. OMR (د آپټیکل مارک پیژندنه) چیک باکسونه او نښې لوستل، د فورمو او ځواب پاڼو تر شا ټیکنالوژي. او IDP / AI-OCR د سټیک په سر کې ناست دی: هغه سیسټمونه چې یوازې نه لوستل کیږي بلکه پوهیږي او عمل کوي.
د OCR پروژې لومړۍ پوښتنه دا ده چې پوه شئ چې ستاسو کوم ډول اسنادو ته اړتیا ده. چاپ شوی رسید او د ډاکټر لاس لیکل شوی نسخه په بشپړه توګه مختلفې ستونزې دي.
د مصنوعي ذهانت په دوره کې OCR: خام OCR اوس یوازې لومړی ګام دی
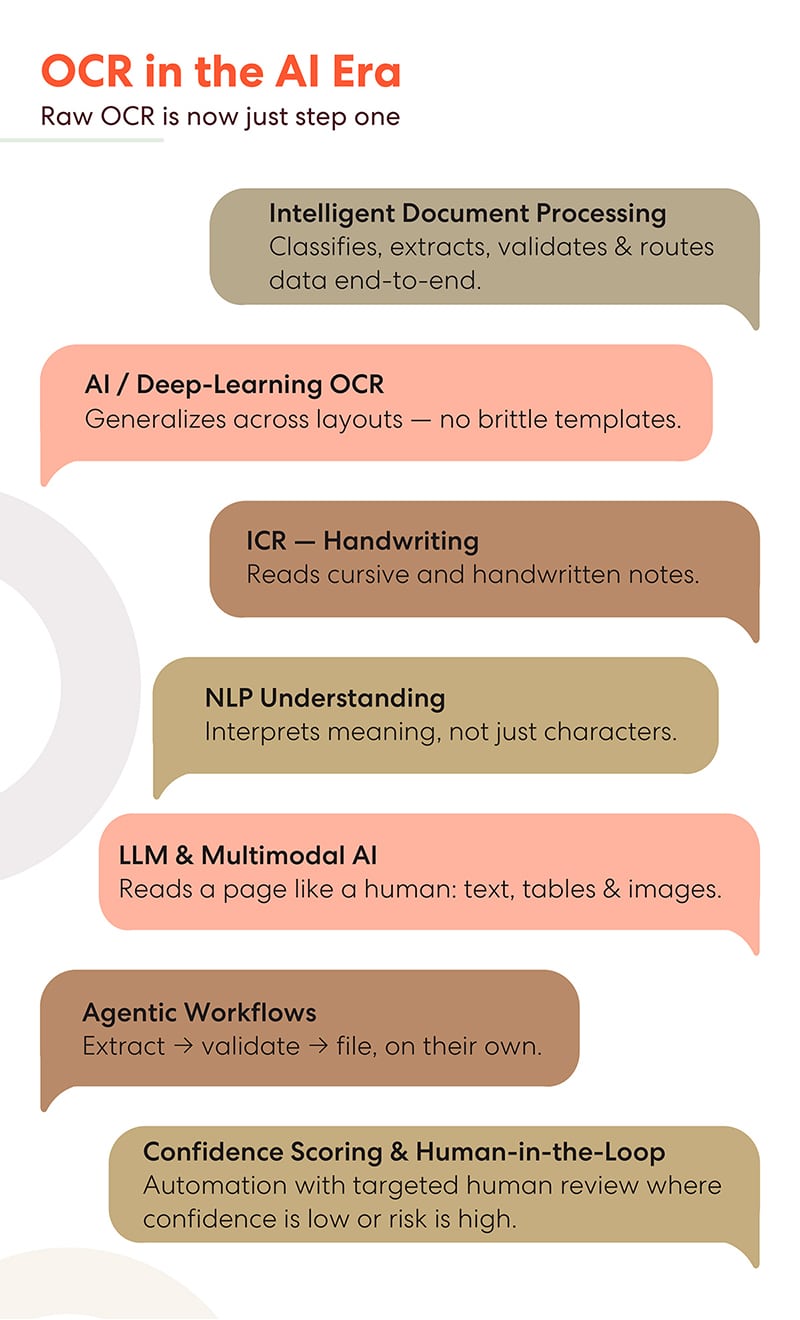
په دې برخه کې تر ټولو ژور بدلون دا دی چې د کرکټر پیژندنه - یو وخت ټول محصول - اوس یوازې د ننوتلو نقطه ده. اووه وړتیاوې عصري سند AI تعریفوي.
د هوښیار اسنادو پروسس کول له پیل څخه تر پایه پورې بشپړ سفر پرمخ وړي: د اسنادو طبقه بندي کول، ساحې استخراج کول، د معلوماتو تایید کول، او د لاسي لاسوهنو پرته پایلې روټ کول.
مصنوعي ذهانت او ژورې زده کړې OCR په ټولو ترتیبونو کې عمومي کوي. زړو سیسټمونو د هر سند فارمیټ لپاره یو نازک ټیمپلیټ ته اړتیا درلوده؛ عصري ماډلونه یو انوائس اداره کوي چې دوی هیڅکله مخکې نه دی لیدلی، ځکه چې دوی زده کړي چې په عمومي ډول انوائسونه څنګه ښکاري.
د ICR د لاس لیکلو پیژندنه د کرسیو او لاس لیکل شوي نوټونو لوستلو حد ته رسیدلې ده - د طبي ریکارډونو، د تحویلي سلیپونو، او آرشیف اسنادو خلاصول چې دمخه له محدودیتونو څخه وو.
د NLP پوهه معنی تشریح کوي، نه یوازې حروف. سیسټم یوازې "نیټ 30" نه لیکي - دا پوهیږي چې دا د تادیې اصطلاح ده.
LLMs او څو ماډل AI یوه پاڼه په هغه ډول لولي لکه څنګه چې یو انسان یې کوي: متن، جدولونه، او انځورونه یوځای، په شرایطو کې. دا د سټیک ترټولو نوی او ګړندی حرکت کوونکی طبقه ده.
د اجنټ کاري جریان لوپ بندوي: استخراج → تایید → فایل، په خپلواکه توګه. سند یوازې نه لوستل کیږي؛ دا اداره کیږي.
د انسان په دننه کې د باور نمرې ورکول دا ټول خوندي کوي چې پلي شي. اتوماتیک کول هغه ځای کې پرمخ ځي چیرې چې باور لوړ وي؛ انسانان یوازې هغه وخت بیاکتنه کوي چیرې چې باور ټیټ وي یا خطر لوړ وي. د هدف شوي بیاکتنې ماډل دا دی چې تصدۍ څنګه سرعت او تفتیش دواړه ترلاسه کوي.
د OCR کارولو قضیې: چیرته چې دا ارزښت وړاندې کوي
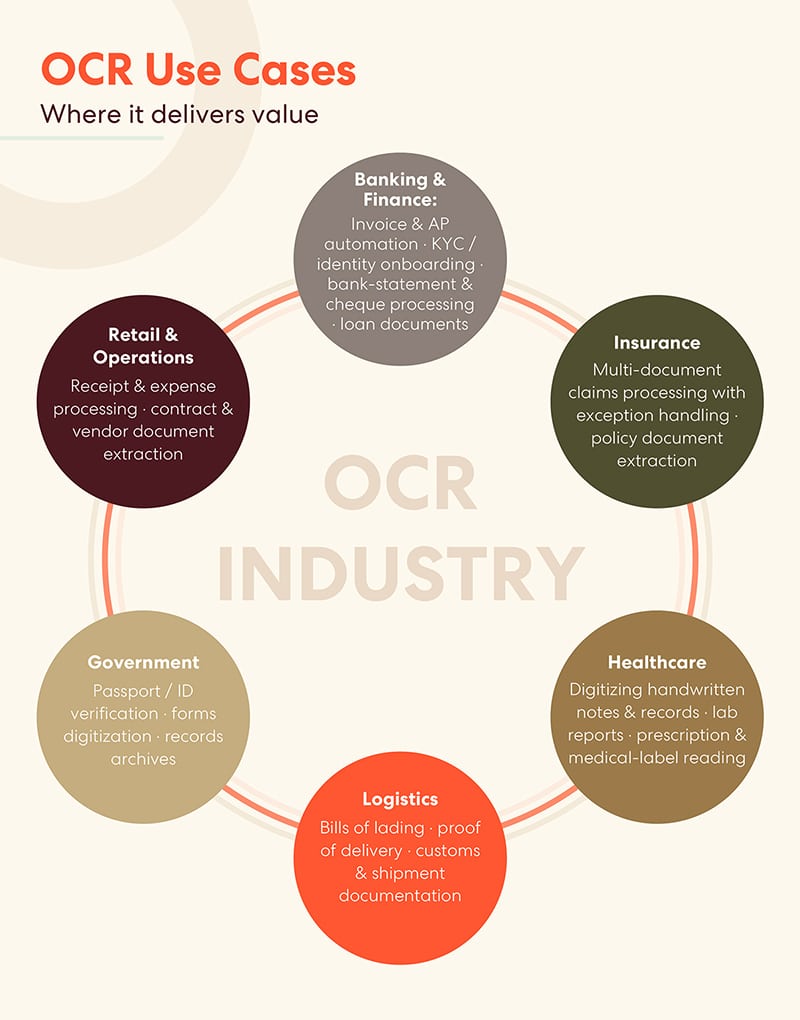
هغه صنعتونه چې OCR په چټکۍ سره غوره کوي هغه دي چې په کاغذ کې ډوب دي.
بانکداري او مالي چارې د بازار مشري کوي — د انوائس او AP اتومات کول، KYC او د هویت داخلول، د بانک بیان او د چک پروسس کول. دا کومه تصادفي خبره نه ده چې BFSI د OCR ترټولو لوی عمودی دی، چې د بازار شاوخوا 21٪ برخه لري. بیمه دا د استثنایی مدیریت او د پالیسۍ سند استخراج سره د څو سندونو ادعاوو پروسس کولو لپاره کاروي — یوه ادعا کولی شي په مختلفو بڼو کې لسګونه اسناد شامل کړي. په روغتیا پاملرنې کې ، OCR په لاس لیکل شوي یادښتونه او ریکارډونه ډیجیټل کوي، د لابراتوار راپورونه لوستل، او نسخې او طبي لیبلونه پروسس کوي، چیرې چې دقت په لفظي ډول د خوندیتوب مسله ده. لوژستیک په اسنادو چلیږي — د بار وړلو بیلونه، د تحویلۍ ثبوت، ګمرکونه او د بار وړلو کاغذونه — او OCR د کاغذ کار د خنډ کیدو څخه د ساتلو له لارې توکي حرکت کوي. حکومت دا د پاسپورټ او ID تصدیق، فورمو پروسس کولو، او د ریکارډونو آرشیفونو ډیجیټل کولو لپاره پلي کوي. او په پرچون پلور او عملیاتو کې ، دا د رسید او لګښت پروسس کولو او د قرارداد او پلورونکي سند استخراج واک ورکوي.
په ټولو شپږو برخو کې دا نمونه: هر چیرې چې یو انسان به د کاغذ څخه معلومات په سیسټم کې بیا ټایپ کول، اوس OCR دا کار ګړندی، ارزانه او د پلټنې لارې سره کوي.
ګټې او ننګونې: صادقانه انځور
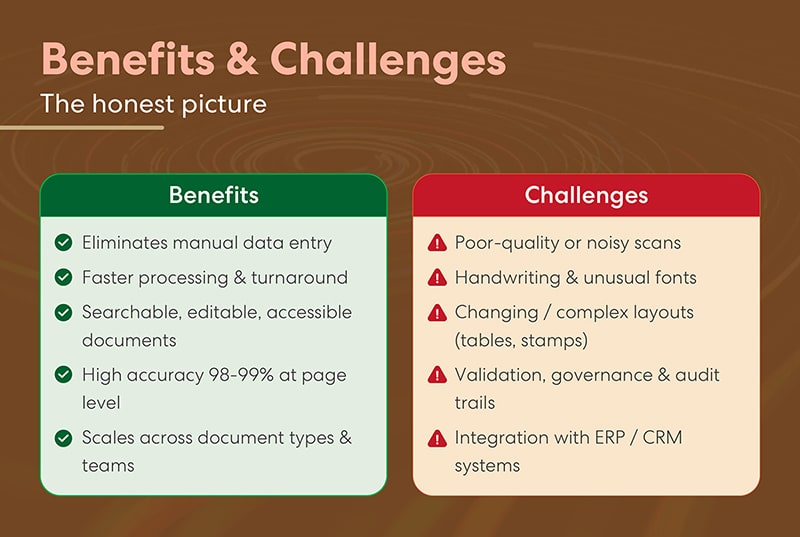
ګټې یې مشخصې دي. OCR د معلوماتو لاسي داخلول له منځه وړي — چې په هر بیک دفتر کې تر ټولو تېروتنه کوونکی او لږ خوښېدونکی کار دی. پروسس کول او بدلون په ډراماتیک ډول ګړندی کیږي. اسناد د مړو سکینونو پرځای د لټون وړ، د سمون وړ او د لاسرسي وړ کیږي. دقت اوس د پاڼې په کچه 98-99٪ ته رسیږي. او عصري سیسټمونه د اسنادو ډولونو او بڼو کې اندازه کوي پرځای یې چې په کوم نا اشنا شی باندې ودریږي.
خو ریښتیني ځای پر ځای کول لاهم ریښتیني ستونزې لري. د کیفیت ټیټوالی یا شورماشور سکینونه د دقت لومړی وژونکی پاتې کیږي - هیڅ ماډل هغه څه نه لولي چې لوستل کیږي. لاس لیکل او غیر معمولي فونټونه لاهم د چاپ شوي متن تعقیبوي. بدلیدونکي او پیچلي ترتیبونه - ځړول شوي میزونه، ټاپې، څو کالم فورمې - استخراج. اعتبار، حکومتداري، او د پلټنې لارې ریښتینې انجینرۍ هڅې ته اړتیا لري، په ځانګړې توګه په تنظیم شوي صنعتونو کې. او د ERP او CRM سیسټمونو سره یوځای کول هغه ځای دی چې ډیری پروژې ودروي: د معلوماتو استخراج یوازې هغه وخت ګټور دی که چیرې دا هغه ځای ته ورسیږي چیرې چې کار په حقیقت کې پیښیږي.
له دې څخه هیڅ یو د معاملې ماتونکي ندي. دا هغه دلیل دی چې د باور نمرې او د انسان په دننه کې بیاکتنه شتون لري - او دلیل یې دا دی چې د سند کیفیت او ښه تشریح شوي روزنې معلومات د ماډل انتخاب په څیر مهم دي.
د OCR بازار: سرچینه او اوسنی
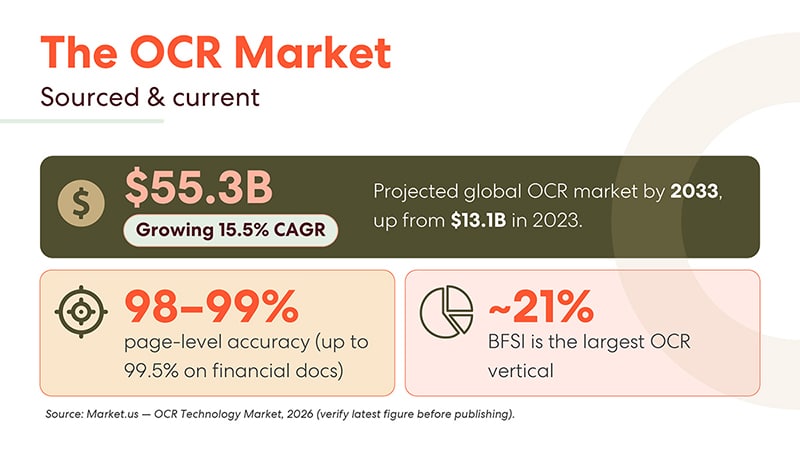
شمېرې فرصت چوکاټ کوي. اټکل کیږي چې د OCR نړیوال بازار به تر ۲۰۳۳ پورې ۵۵.۳ ملیارد ډالرو ته ورسیږي ، چې په ۲۰۲۳ کې د ۱۳.۱ ملیارد ډالرو څخه لوړ دی - چې ۱۵.۵٪ CAGR دی . د پاڼې کچې دقت ۹۸-۹۹٪ ته رسیدلی ، چې په مالي اسنادو کې لاهم لوړ شوی. او BFSI د بازار په شاوخوا ۲۱٪ کې ترټولو لوی عمودی دی ، چې دا د دې نښه ده چې ROI لومړی ثابتیږي.
بل څه دي: د ۲۰۲۶ کال لپاره د OCR رجحانات
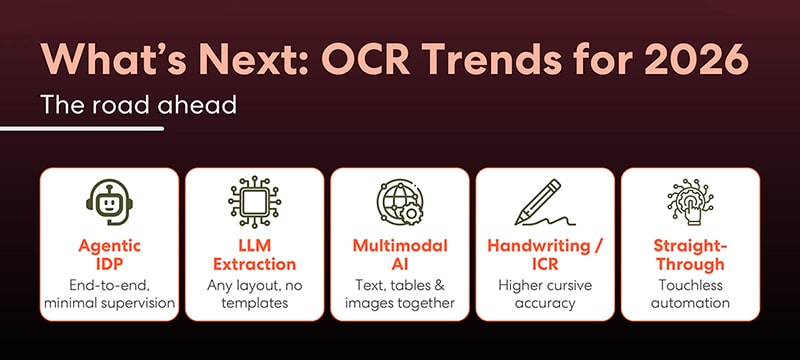
پنځه رجحانات د راتلونکي لاره تعریفوي. اجنټیک IDP - د اسنادو کاري جریان چې د خوښۍ په لاره کې د انسان لمس پرته له پای څخه تر پایه پورې پرمخ ځي. د LLM لخوا پرمخ وړل شوي استخراج - د لوی ژبې ماډلونو کارول ترڅو د اسنادو څخه جوړښتي معلومات د لږ یا هیڅ ټیمپلیټ تنظیم سره راوباسي. ملټي موډل AI - هغه ماډلونه چې متن، جدولونه او انځورونه په یوه پاس کې پروسس کوي، اسناد د ټوټو پرځای په بشپړ ډول پوهیږي. لاس لیکنه او ICR پرمختګونه - په دوامداره توګه د کرسیو او ګډوډ لاس لیکنې په اړه دقت لوړیږي، د اسنادو ټولګي خلاصوي چې دمخه یوازې لاسي وو. او مستقیم پروسس کول - پای هدف: هغه اسناد چې راځي، لوستل کیږي، تایید کیږي، او د صفر انساني لمس سره ثبت کیږي.
لارښوونه بې له شکه ده: د اسنادو له لوستلو څخه تر سمبالولو پورې.
لاندې کرښه
په ۲۰۲۶ کال کې OCR نور د انځورونو په متن بدلولو پورې اړه نلري - دا د کاغذ کار بشپړ شوي کار ته اړولو پورې اړه لري. د سوداګرۍ ۸۰٪ معلومات په غیر منظم اسنادو کې بند دي او بازار د ۵۵ ملیارد ډالرو په لور لوړیږي، د ډیری سازمانونو لپاره پوښتنه دا نه ده چې ایا OCR غوره کړي، بلکې دا ده چې څومره پورته لاړ شي: ساده متن استخراج، جوړښتي IDP، یا په بشپړ ډول اجنټیک سند کاري جریان.
اسناد لا دمخه راټول شوي دي. د هغوی د لوستلو - او په هغوی د عمل کولو - ټیکنالوژي چمتو ده.