د سافټویر پراختیا په څیر چې په کوډ کار کوي، د مصنوعي استخباراتو او ماشین زده کړې ماډلونو رامینځته کول د لوړ کیفیت معلوماتو ته اړتیا لري. ماډلونه د تولید په ډیری مرحلو کې په سمه توګه لیبل شوي او تشریح شوي معلوماتو ته اړتیا لري ځکه چې الګوریتم باید د دندو ترسره کولو لپاره په دوامداره توګه وروزل شي.
خو، د کیفیت لرونکي معلوماتو ترلاسه کول ګران دي. ځینې وختونه، ډیټاسیټونه ممکن له غلطیو ډک وي چې کولی شي د پروژې پایله اغیزمنه کړي. د ډیټا ساینس متخصصین به لومړی وي چې تاسو ته ووایی چې دوی د معلوماتو د ارزونې او تحلیل کولو په پرتله د معلوماتو په پاکولو او سکریب کولو کې ډیر وخت تیروي.
ولې په ډیټاسیټ کې په لومړي ځای کې غلطۍ شتون لري؟
ولې دا اړینه ده چې دقیق روزنیز ډیټاسیټونه ولرئ؟
د مصنوعي ذهانت روزنې معلوماتو تېروتنې کوم ډولونه دي ؟ او څنګه یې مخنیوی وشي؟
راځئ چې د ځینو احصایو سره پیل وکړو.
د MIT کمپیوټر ساینس او مصنوعي استخباراتو لابراتوار کې د څیړونکو یوې ډلې لس لوی ډیټاسیټونه وڅیړل چې له 100,000 څخه ډیر ځله حواله شوي دي. څیړونکو وموندله چې د ټولو تحلیل شوي ډیټاسیټونو په اوږدو کې د غلطۍ اوسط کچه نږدې 3.4٪ وه . دا هم وموندل شوه چې ډیټاسیټونه د مختلفو ډولونو غلطیو سره مخ وو ، لکه د عکسونو، آډیو او متن احساساتو غلط لیبل کول.
ولې په ډیټاسیټ کې په لومړي ځای کې غلطۍ شتون لري؟
د مثال په توګه، تصور وکړئ چې د خپل دفتر مرستیال څخه وغواړئ چې ستاسو د ټولو موقعیت سوداګرۍ په اړه بشپړ معلومات راټول کړي او په لاسي ډول یې په سپریڈ شیټ کې دننه کړئ. په یو وخت یا بل کې، یوه تېروتنه به واقع شي. پته غلطه کیدی شي، نقل کیدی شي، یا د معلوماتو بې اتفاقي واقع شي.
په معلوماتو کې تېروتنې هم واقع کیدی شي که چیرې د سینسر لخوا راټول شوي د تجهیزاتو ناکامۍ، سینسر خرابیدل، یا ترمیم له امله.
ولې دا اړینه ده چې دقیق روزنیز ډیټاسیټونه ولرئ؟
د ماشین زده کړې ټول الګوریتمونه ستاسو له چمتو شوي معلوماتو څخه زده کړه کوي. لیبل شوي او تشریح شوي معلومات ماډلونو سره د اړیکو موندلو، مفاهیمو پوهیدو، پریکړې کولو او د دوی فعالیت ارزولو کې مرسته کوي. دا اړینه ده چې خپل د ماشین زده کړې ماډل د غلطۍ څخه پاک ډیټاسیټونو کې وروزل شي پرته لدې چې د اړوندو لګښتونو یا روزنې لپاره اړین وخت په اړه اندیښنه ولرئ. لکه څنګه چې په اوږد مهال کې، هغه وخت چې تاسو د کیفیت لرونکي معلوماتو ترلاسه کولو لپاره مصرف کوئ ستاسو د AI پروژو پایله به لوړه کړي.
د دقیقو معلوماتو په اړه ستاسو ماډلونو ته روزنه ورکول به ستاسو ماډلونو ته اجازه ورکړي چې دقیق وړاندوینې وکړي او د ماډل فعالیت ته وده ورکړي . کارول شوي کیفیت، مقدار، او الګوریتمونه ستاسو د مصنوعي ذهانت پروژې بریالیتوب ټاکي.
د AI روزنې ډیټا غلطیو ډولونه کوم دي؟
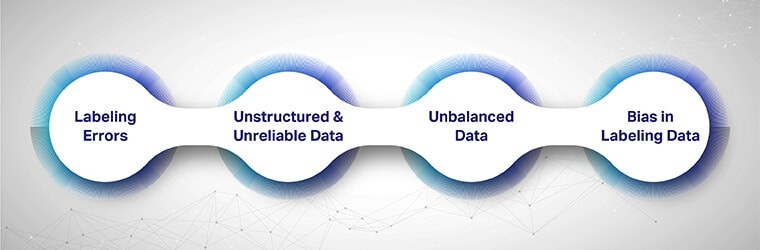
د لیبل کولو تېروتنې، د اعتبار وړ ډاټا، غیر متوازن ډاټا، د معلوماتو تعصب
موږ به د روزنې څلور خورا عام ډیټا غلطۍ او د دوی د مخنیوي لارې وګورو.
د لیبل کولو تېروتنې
د لیبل کولو غلطۍ د روزنې معلوماتو کې موندل شوي ترټولو عام غلطیو څخه دي . که چیرې د ماډل ازموینې ډاټا غلط لیبل شوي ډیټاسیټونه ولري، نو پایله به یې حل ګټور نه وي. د معلوماتو ساینس پوهان به د ماډل د فعالیت یا کیفیت په اړه دقیق یا معنی لرونکي پایلې ونه کړي.
د لیبل کولو تېروتنې په مختلفو بڼو کې راځي. موږ د دې ټکي د لا پراختیا لپاره یو ساده مثال کاروو. که چیرې د معلوماتو تشریح کونکي په عکسونو کې د هرې پیشو په شاوخوا کې د باؤنډینګ بکسونو رسم کولو ساده دنده ولري ، نو د لیبل کولو لاندې ډول ډول خطاګانې ممکن واقع شي.
- ناسم فټ: د ماډل اوور فټینګ هغه وخت پیښیږي کله چې تړل شوي بکسونه د څیز (بلی) سره نږدې نه وي ، د ټاکل شوي شی شاوخوا څو تشې پریږدي.
- ورک شوي لیبلونه: پدې حالت کې ، تشریح کونکی ممکن په عکسونو کې د پیشو لیبل کول له لاسه ورکړي.
- د لارښوونې غلط تفسیر: تشریح کونکو ته ورکړل شوي لارښوونې روښانه ندي. په عکسونو کې د هرې پیشو په شاوخوا کې د یو تړل شوي بکس د ځای په ځای کولو پرځای، تشریح کونکي یو تړلی بکس ځای په ځای کوي چې ټولې پیشوګانې پکې شاملې دي.
- د اختلاطاتو اداره کول: د دې پر ځای چې د پیشو د لیدلو وړ برخې په شاوخوا کې د تړل شوي بکس ځای په ځای کړي، تشریح کوونکی د یوې برخې لیدل شوي پیشو په تمه شوي شکل شاوخوا تړل شوي بکسونه ځای په ځای کوي.
غیر منظم او غیر معتبر معلومات
د ML پروژې ساحه د ډیټاسیټ ډول پورې اړه لري چې دا روزل کیږي. سوداګرۍ باید خپلې سرچینې د ډیټاسیټونو ترلاسه کولو لپاره وکاروي چې تازه ، معتبر او د اړتیا وړ پایلو نمایندګي وي.
کله چې تاسو موډل د ډیټا په اړه روزئ چې تازه شوي ندي ، دا کولی شي په غوښتنلیک کې د اوږدې مودې محدودیتونو لامل شي. که تاسو خپل ماډلونه په بې ثباته او نه کارول کیدونکي ډیټا باندې روزئ ، نو دا به د AI ماډل ګټورتوب منعکس کړي.
غیر متوازن معلومات
د معلوماتو هرډول عدم توازن ستاسو د ماډل فعالیت کې د تعصب لامل کیدی شي. کله چې د لوړ فعالیت یا پیچلي ماډلونو جوړول، د روزنې ډاټا جوړښت باید په پام کې ونیول شي. د معلوماتو عدم توازن په دوه ډوله کیدی شي:
- د ټولګي انډول: د ټولګي عدم توازن هغه وخت رامینځته کیږي کله چې د روزنې معلومات خورا غیر متوازن ټولګي ویش لري. په بل عبارت، هیڅ استازی ډیټاسیټ شتون نلري. کله چې په ډیټاسیټونو کې ټولګي عدم توازن شتون ولري، دا د ریښتینې نړۍ غوښتنلیکونو سره د جوړولو په وخت کې ډیری مسلې رامینځته کولی شي.
د مثال په توګه، که الګوریتم د پیشوګانو پیژندلو لپاره روزل کیږي، د روزنې ډاټا یوازې په دیوالونو کې د پیشوګانو انځورونه لري. بیا ماډل به ښه ترسره کړي کله چې په دیوالونو کې پیشوګانې وپیژني مګر په مختلف شرایطو کې به خراب کار وکړي. - د معلوماتو تازه کول: هیڅ ماډل په بشپړ ډول تازه نه دی. ټول ماډلونه د زوال سره مخ دي، لکه څنګه چې ریښتیني نړۍ چاپیریال په دوامداره توګه بدلیږي. که چیرې ماډل د دې چاپیریال بدلونونو په اړه په منظمه توګه تازه نشي، نو د دې ګټورتیا او ارزښت احتمال کم شوی.
د مثال په توګه، تر دې وروستیو پورې، د سپوتنیک اصطالح لپاره د سرسري لټون کیدای شي د روسیې کیریر راکټ په اړه پایلې ترلاسه کړي. په هرصورت ، د وبا څخه وروسته د لټون پایلې به په بشپړ ډول توپیر ولري او د روسیې کوویډ واکسین څخه ډکې وي.
د لیبل کولو ډاټا کې تعصب
د روزنې ډیټا کې تعصب یوه موضوع ده چې اوس او بیا راپورته کیږي. د معلوماتو تعصب د لیبل کولو پروسې په جریان کې یا د تشریح کونکو لخوا هڅول کیدی شي. د ډیټا تعصب هغه وخت رامینځته کیدی شي کله چې د تشریح کونکو لوی متفاوت ټیم کاروي یا کله چې د لیبل کولو لپاره ځانګړي شرایط اړین وي.
د تعصب کمول هغه وخت ممکن دي کله چې تاسو د نړۍ له ګوټ ګوټ څخه تشریح کونکي ولرئ یا د سیمې ځانګړي تشریح کونکي دندې ترسره کړي. که تاسو د نړۍ له ګوټ ګوټ څخه ډیټاسیټونه کاروئ، نو ډیر احتمال شتون لري چې تشریح کونکي په لیبل کولو کې غلطۍ وکړي.
د مثال په توګه، که تاسو د نړۍ له مختلفو خواړو سره کار کوئ، په انګلستان کې یو تشریح کوونکی ممکن د آسیایانو د خوړو غوره توبونو سره بلد نه وي. پایله لرونکی ډیټاسیټ به د انګلیسي په ګټه تعصب ولري.
د AI روزنې ډیټا غلطیو څخه څنګه مخنیوی وشي؟
د روزنې ډیټا غلطیو څخه مخنیوي غوره لاره د لیبل کولو پروسې په هر مرحله کې د کیفیت کنټرول سخت چیک پلي کول دي.
تاسو کولی شئ د معلوماتو د لیبل کولو غلطیو څخه مخنیوی وکړئ د تشریح کونکو ته د واضح او دقیق لارښوونو په ورکولو سره. دا کولی شي د ډیټاسیټ یووالي او دقت ډاډمن کړي.
د ډیټاسیټونو کې د عدم توازن څخه د مخنیوي لپاره، وروستي، تازه شوي، او استازیتوب کونکي ډیټاسیټونه واخلئ. ډاډ ترلاسه کړئ چې ډیټاسیټونه نوي او نه کارول شوي دي مخکې لدې چې روزنه او د ML ماډلونه ازموینه وکړئ.
یوه پیاوړې مصنوعي ذهانت پروژه په تازه، بې طرفه او باوري روزنیزو معلوماتو باندې وده کوي ترڅو په غوره توګه فعالیت وکړي. دا خورا مهمه ده چې د لیبل کولو او ازموینې په هره مرحله کې د کیفیت مختلف چکونه او اقدامات ترسره شي. د روزنې غلطۍ کولی شي یوه مهمه مسله شي که چیرې دوی د پروژې پایلې اغیزمن کولو دمخه پیژندل شوي او اصلاح نشي.
ستاسو د ML پر بنسټ پروژې لپاره د کیفیت لرونکي AI روزنې ډیټاسیټونو ډاډ ترلاسه کولو لپاره غوره لاره دا ده چې د تشریح کونکو یوه متنوع ډله وګمارئ چې د پروژې لپاره اړین ډومین پوهه او تجربه ولري.
تاسو کولی شئ په شایپ کې د تجربه لرونکو تشریح کونکو ټیم سره چټک بریالیتوب ترلاسه کړئ څوک چې د مصنوعي ذهانت پر بنسټ مختلفو پروژو ته هوښیار لیبلینګ او تشریح خدمات چمتو کوي. موږ ته زنګ ووهئ، او په خپلو مصنوعي ذهانت پروژو کې کیفیت او فعالیت ډاډمن کړئ.