مصنوعي ذهانت، لوی معلومات، او د ماشین زده کړه په ټوله نړۍ کې په پالیسي جوړونکو، سوداګرۍ، ساینس، رسنیو او مختلفو صنعتونو باندې خپل نفوذ ته دوام ورکوي. راپورونه ښیي چې د مصنوعي ذهانت د منلو کچه اوس مهال په ۲۰۲۲ کال کې ۳۵٪ ده - چې د ۲۰۲۱ کال په پرتله ۴٪ زیاتوالی دی. د راپورونو له مخې، ۴۲٪ نور شرکتونه د خپل سوداګرۍ لپاره د مصنوعي ذهانت ډیری ګټې لټوي.
د مصنوعي ذهانت د ډېرو نوښتونو او د ماشین زده کړې حل لارو ځواک معلومات دي. مصنوعي ذهانت یوازې د الګوریتم د تغذیه کولو په څیر ښه کیدی شي. د ټیټ کیفیت معلومات کولی شي د ټیټ کیفیت پایلو او ناسم وړاندوینو پایله ولري.
که څه هم د ML او AI حل لارې پراختیا ته ډیره پاملرنه شوې ده، د دې پوهاوی چې د کیفیت لرونکي ډیټاسیټ په توګه څه وړتیا لري ورک دی. پدې مقاله کې، موږ د کیفیت لرونکي AI روزنې معلوماتو مهال ویش نیویګیټ کوو او د معلوماتو راټولولو او روزنې د پوهاوي له لارې د AI راتلونکی پیژنو.
د AI روزنې ډیټا تعریف
کله چې د ML حل جوړ کړئ، د روزنې ډیټاسیټ مقدار او کیفیت مهم دی. د ML سیسټم نه یوازې د متحرک، بې طرفه، او ارزښتناکه روزنې ډیټا لوی مقدار ته اړتیا لري، بلکې دا ورته ډیره اړتیا لري.
مګر د AI روزنې معلومات څه دي؟
د AI روزنې ډیټا د لیبل شوي ډیټا ټولګه ده چې د ML الګوریتم روزنې لپاره کارول کیږي ترڅو دقیق وړاندوینې وکړي. د ML سیسټم هڅه کوي چې نمونې وپیژني او وپیژني، د پیرامیټونو ترمنځ اړیکې درک کړي، اړین پریکړې وکړي، او د روزنې معلوماتو پراساس ارزونه وکړي.
د مثال په توګه د ځان چلولو موټرو مثال واخلئ. د ځان چلولو د ML ماډل لپاره د روزنې ډیټاسیټ باید د موټرو لیبل شوي عکسونه او ویډیوګانې شاملې وي، پیاده چلونکي، د سړک نښې، او نور وسایط.
په لنډه توګه، د ML الګوریتم کیفیت لوړولو لپاره، تاسو د ښه جوړښت، تشریح شوي، او لیبل شوي روزنې ډیټا لوی مقدار ته اړتیا لرئ.
د کیفیت روزنې ډیټا اهمیت او د هغې ارتقا
د لوړ کیفیت روزنې ډیټا د AI او ML ایپ پراختیا کې کلیدي آخذه ده. معلومات د مختلفو سرچینو څخه راټول شوي او په غیر منظم شکل کې وړاندې کیږي چې د ماشین زده کړې موخو لپاره مناسب ندي. د کیفیت روزنې ډاټا - لیبل شوي، تشریح شوي، او ټګ شوي - تل په منظم شکل کې وي - د ML روزنې لپاره مثالی.
د کیفیت روزنې ډیټا د ML سیسټم لپاره دا اسانه کوي چې شیان وپیژني او د دمخه ټاکل شوي ځانګړتیاو سره سم یې طبقه بندي کړي. ډیټاسیټ کولی شي خراب ماډل پایلې ترلاسه کړي که طبقه بندي سمه نه وي.
د AI روزنې ډیټا لومړنۍ ورځې
سره له دې چې مصنوعي ذهانت په اوسني سوداګرۍ او څېړنیزې نړۍ کې واکمن دی، د مصنوعي ذهانت د واکمنۍ څخه مخکې لومړنۍ ورځې خورا توپیر درلودې.
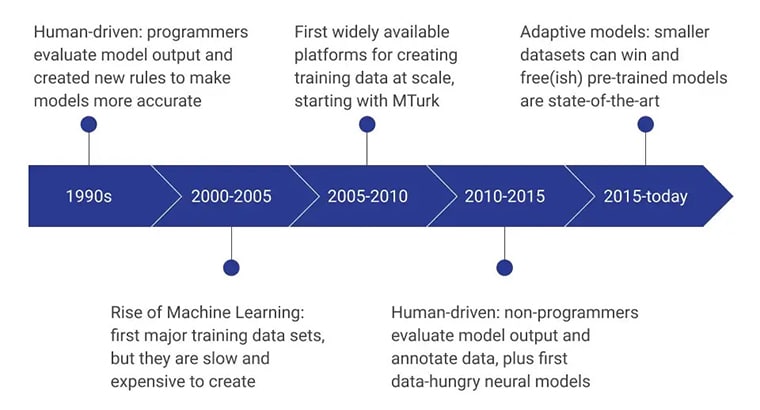
په راتلونکو څو کلونو کې په غیر پروګرامرانو باندې د ډیټا ماډلونو جوړولو او ارزولو تمرکز کوي. اوس مهال، تمرکز د مخکینۍ روزل شوي ماډلونو باندې دی چې د پرمختللي روزنې معلوماتو راټولولو میتودونو په کارولو سره رامینځته شوي.
مقدار پر کیفیت
کله چې په تیرو وختونو کې د مصنوعي ذهانت روزنې ډیټاسیټونو بشپړتیا ارزونه کوله، د معلوماتو ساینس پوهانو د کیفیت په پرتله د مصنوعي ذهانت روزنې ډیټا مقدار باندې تمرکز کاوه.
د مثال په توګه، یو عام غلط فهم و چې لوی ډیټابیسونه دقیق پایلې وړاندې کوي. په دې باور وو چې د معلوماتو بشپړ حجم د ډیټا ارزښت یو ښه شاخص دی. مقدار یوازې یو له لومړنیو فاکتورونو څخه دی چې د ډیټا سیټ ارزښت ټاکي - د ډیټا کیفیت رول پیژندل شوی.
دا پوهاوی چې د معلوماتو کیفیت د معلوماتو بشپړتیا، اعتبار، اعتبار، شتون او وخت پورې اړه لري زیات شو. تر ټولو مهمه دا چې د پروژې لپاره د معلوماتو مناسبیت د راټول شویو معلوماتو کیفیت ټاکي.
د کمزوري روزنې ډیټا له امله د لومړني AI سیسټمونو محدودیتونه
د روزنې ضعیف معلومات ، د پرمختللي کمپیوټري سیسټمونو نشتوالي سره یوځای د AI سیسټمونو د ډیری نه پوره کیدو ژمنو یو لامل و.
د کیفیت روزنې ډیټا نشتوالي له امله، د ML حلونه نشي کولی په سمه توګه د عصبي څیړنې پراختیا ودروي بصري نمونې وپیژني. که څه هم ډیری څیړونکو د خبرې شوي ژبې پیژندلو ژمنې په ګوته کړې، د وینا پیژندنې وسیلو څیړنه یا پراختیا نشي کولی د وینا ډیټاسیټونو نشتوالي څخه مننه وکړي. د لوړ پای AI وسیلو رامینځته کولو کې بل لوی خنډ د کمپیوټرونو د کمپیوټري او ذخیره کولو وړتیاو نشتوالی و.
د کیفیت روزنې ډیټا ته بدلون
په پوهاوي کې د پام وړ بدلون راغلی چې د ډیټاسیټ کیفیت مهم دی. د دې لپاره چې د ML سیسټم په سمه توګه د انساني استخباراتو او تصمیم نیولو وړتیاوې تقلید کړي، دا باید د لوړ حجم، لوړ کیفیت روزنې معلوماتو ته وده ورکړي.
د خپل ML ډیټا په اړه د سروې په توګه فکر وکړئ - د ډیټا نمونې اندازه څومره لویه وي، وړاندوینه یې هم ښه وي. که چیرې د نمونې ډیټا ټول متغیرات پکې شامل نه وي، نو ممکن نمونې ونه پیژني یا ناسمې پایلې ونه راوړي.
د AI ټیکنالوژۍ کې پرمختګ او د غوره روزنې ډیټا ته اړتیا

د دې پوهیدل چې د روزنې غوره ډیټا د باور وړ ML ماډلونو چانس ډیروي د معلوماتو راټولولو ، تشریح کولو ، او لیبل کولو میتودونو ته وده ورکوي. د معلوماتو کیفیت او تړاو په مستقیم ډول د AI ماډل کیفیت اغیزه کوي.

د معلوماتو کیفیت او دقت باندې تمرکز ډیر شوی
د ML ماډل لپاره چې دقیقې پایلې چمتو کول پیل کړي ، دا د کیفیت ډیټاسیټونو ته تغذیه کیږي چې د تکراري ډیټا پاکولو مرحلو څخه تیریږي.
د مثال په توګه، یو انسان کولی شي د سپي یو ځانګړی نسل په څو ورځو کې د سپي نسل ته معرفي کولو وروسته وپیژني - د انځورونو، ویډیوګانو، یا په شخص کې. انسانان د خپلو تجربو او اړوندو معلوماتو څخه کار اخلي ترڅو د اړتیا په وخت کې دا پوهه یاد او راوباسي. بیا هم، دا د ماشین لپاره په اسانۍ سره کار نه کوي. ماشین باید په واضح ډول تشریح شوي او لیبل شوي عکسونو سره تغذیه شي - په سلګونو یا زرګونو - د دې ځانګړي نسل او نورو نسلونو سره د ارتباط لپاره.
د مصنوعي ذهانت ماډل د روزنې شویو معلوماتو سره د ریښتینې نړۍ کې وړاندې شوي معلوماتو سره د اړیکو له لارې د پایلو وړاندوینه کوي . که چیرې د روزنې معلومات اړونده معلومات شامل نه وي نو الګوریتم بې ګټې کیږي.
د متنوع او نمایشي روزنې معلوماتو اهمیت
یو ډیټاسیټ د یو ځانګړي نفوس، نسل، جندر، انتخاب، او فکري نظرونو په وړاندې تعصب کیدی شي، کوم چې کولی شي د ناسم ماډل لامل شي.
دا مهمه ده چې د ټولو معلوماتو راټولولو پروسې جریان ډاډمن کړئ، په شمول د موضوع حوض غوره کول، کیوریشن، تشریح، او لیبل کول، په کافي ډول متنوع، متوازن، او د خلکو استازیتوب کوي.

د AI روزنې ډیټا راتلونکی
د AI ماډلونو راتلونکی بریالیتوب د روزنې ډیټا کیفیت او مقدار پورې اړه لري چې د ML الګوریتمونو روزنې لپاره کارول کیږي. دا مهمه ده چې دا وپیژندل شي چې د معلوماتو کیفیت او مقدار ترمنځ دا اړیکه د دندې مشخصه ده او هیڅ مشخص ځواب نلري.
په نهایت کې، د روزنې ډیټا سیټ مناسبیت د دې وړتیا لخوا تعریف شوی چې د هغه هدف لپاره چې دا جوړ شوی دی د باور وړ ښه ترسره کولو وړتیا لري.
د معلوماتو راټولولو او تشریح کولو تخنیکونو کې پرمختګ
څرنګه چې ML د فیډ ډاټا سره حساس دی، دا د معلوماتو راټولولو او تشریح کولو پالیسیو ساده کولو لپاره خورا مهم دی. د معلوماتو په راټولولو، کیوریشن، غلط بیان، نیمګړتیا اندازه، ناسم منځپانګې، د معلوماتو نقل، او غلط اندازه کول د معلوماتو د ناکافي کیفیت سره مرسته کوي.
د ډیټا کان کیندنې ، ویب سکریپینګ ، او ډیټا استخراج له لارې د اتوماتیک ډیټا راټولول د ګړندي ډیټا تولید لپاره لاره هواره کوي. برسیره پردې، مخکې له مخکې بسته شوي ډیټاسیټونه د چټک فکس ډیټا راټولولو تخنیک په توګه کار کوي.
کراوډ سورسنګ د معلوماتو راټولولو یوه بله مهمه طریقه ده. پداسې حال کې چې د معلوماتو د اعتبار تصدیق نشي کیدی، دا د عامه انځور راټولولو لپاره یوه غوره وسیله ده. په پای کې، د معلوماتو راټولولو متخصصین هم د ځانګړو موخو لپاره سرچینه شوي معلومات چمتو کوي.
د روزنې په معلوماتو کې په اخلاقي ملحوظاتو ډیر ټینګار
څرنګه چې اوس په ډیټا کې د مخ عکسونو، د ګوتو نښانونو، غږ ثبتولو، او نورو مهمو بایومیټریک معلوماتو څخه هرڅه شامل دي، نو دا خورا مهم کیږي چې د قانوني او اخلاقي کړنو تعقیب یقیني کړي ترڅو د قیمتي قوانینو او شهرت ته زیان رسولو مخه ونیسي.
په راتلونکي کې د حتی غوره کیفیت او متنوع روزنې ډیټا احتمال
په راتلونکي کې د لوړ کیفیت او متنوع روزنیزو معلوماتو لپاره لوی ظرفیت شتون لري . د معلوماتو کیفیت په اړه د پوهاوي او د معلوماتو چمتو کونکو شتون څخه مننه چې د AI حلونو کیفیت غوښتنې پوره کوي.
د اوسني ډیټا چمتو کونکي په اخلاقي او قانوني ډول د متنوع ډیټاسیټونو لوی مقدار سرچینه کولو لپاره د ځمکني ټیکنالوژیو کارولو کې ماهر دي. دوی د کور دننه ټیمونه هم لري ترڅو د مختلف ML پروژو لپاره دودیز شوي ډیټا لیبل ، تشریح او وړاندې کړي.

پایله
دا مهمه ده چې د لوړ پای مصنوعي ذهانت ماډلونو د پراختیا لپاره د معلوماتو او کیفیت په اړه د ژورې پوهې سره د باور وړ پلورونکو سره ملګرتیا وکړئ . شایپ د تشریح کولو مخکښ شرکت دی چې د دودیز شوي معلوماتو حلونو چمتو کولو کې ماهر دی چې ستاسو د مصنوعي ذهانت پروژې اړتیاوې او اهداف پوره کوي. زموږ سره ملګرتیا وکړئ او هغه وړتیاوې، ژمنتیا، او همکاري وپلټئ چې موږ یې میز ته راوړو.