د آپټیکل کرکټر پیژندنه اوس د رسید سکین کولو، د ID تصدیق، د رسید اتومات کولو، د تاریخي آرشیف ډیجیټل کولو، او سټایلس پر بنسټ د نوټ ایپسونو ځواک ورکوي. د OCR بازار تمه کیږي چې تر 2030 پورې د 14.8٪ CAGR (ګرینډ ویو ریسرچ، 2024) سره 32.90 ملیارد ډالرو ته ورسیږي، د هوښیار کرکټر پیژندنې سره - د OCR د لاس لیکلو لوستلو څانګه - ترټولو ګړندۍ وده کوي. که تاسو د اسنادو تحلیل، د صحنې متن کشف، یا د لاس لیکلو لیږد جوړوئ، هغه OCR ډیټاسیټ چې تاسو یې روزنه ورکوئ ستاسو د دقت حد ټاکي. دا لارښود 22 وړیا، خلاصې سرچینې OCR ډیټاسیټ پوښي - پشمول د غوره لاس لیکلو ډیټاسیټ - د کارونې قضیې لخوا تنظیم شوي او د 2024 پورې د قوي خپرونو سره تازه شوي.
کلیدي ټکي
- OCR (د نظري کرکټر پیژندنه): هغه ټیکنالوژي چې د چاپ شوي، صحنې یا لاس لیکل شوي متن انځورونه د ماشین لوستلو وړ معلوماتو ته بدلوي.
- د OCR ډیټاسیټونه په پنځو ډلو ویشل شوي دي: سند/بڼه، د صحنې متن، عدد/کرکټر، لاس لیکل، او څو ژبني.
- د OCR ډیټاسیټونو سند جوړښتي پاڼې لکه فورمې او رسیدونه ونیسئ؛ د صحنې متن ډیټاسیټونه متن "په ځنګل کې" ونیسئ.
- IAM، MNIST، ICDAR، او SROIE د څیړنې په اوږدو کې تر ټولو ډیر یاد شوي OCR معیارونه پاتې دي.
- د جواز شرایط په پراخه کچه توپیر لري - د سوداګریزې روزنې دمخه د هر OCR ډیټاسیټ تصدیق کړئ.
OCR (د نظری کرکټر پیژندنه) څه شی دی؟
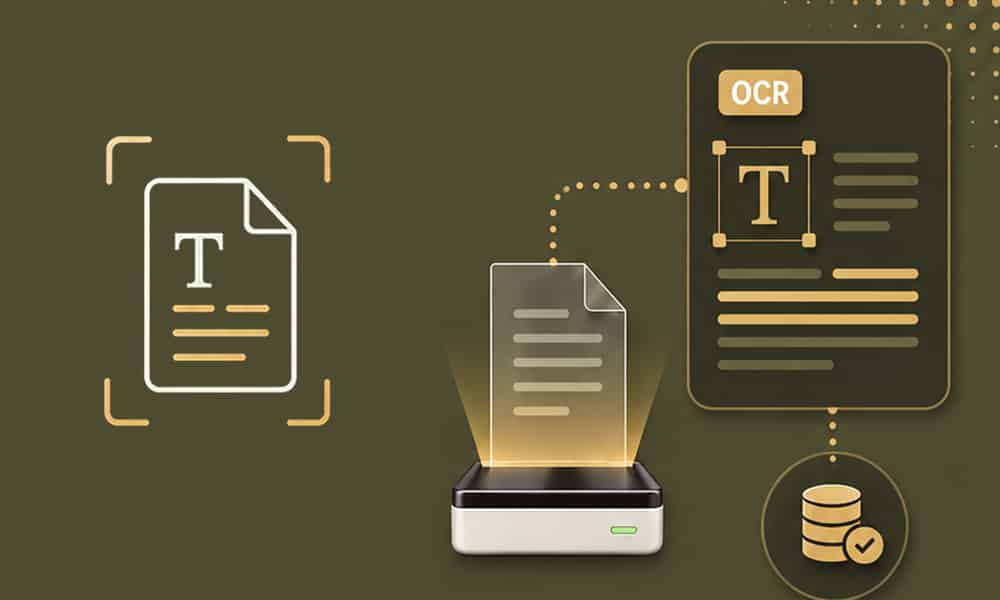
OCR هغه ټیکنالوژي ده چې د اسنادو مختلف ډولونه لکه سکین شوي کاغذ اسناد، PDFs، یا د متن عکسونه د ترمیم وړ او د لټون وړ ډیټا بدلوي. دا کار کوي:
- په انځور کې د متن جوړښت تحلیل
- متن په کرښو او حروفونو ویشل
- د دې بصري کرکټرونو بدلول د ماشین لوستلو وړ متن ته
عام استعمالونه پدې کې شامل دي:
- سکین شوي اسناد د ترمیم وړ متن فایلونو ته بدلول
- د چاپ شوي کتابونو ډیجیټل کول
- د عکسونو څخه متن استخراج
- د لاس لیکل شوي نسخې ډیجیټل متن ته بدلول
- د جواز پلیټ پیژندنه
تاسو څنګه سم OCR ډیټاسیټ غوره کوئ؟
د OCR ډیټاسیټ غوره کول په څلورو فکتورونو پورې اړه لري: د متن ډول، د نیولو چاپیریال، د تشریح ګرینولریټي، او جواز. چاپ شوی سند OCR د لاس لیکل شوي کرسیو یا منحني صحنې متن په پرتله مختلف روزنې ډیټا ته اړتیا لري. د سند ډیټاسیټ د رسیدونو، فورمو او رسیدونو سره سمون لري؛ د صحنې متن ډیټاسیټ د لاسلیک او محصول لوستلو سره سمون لري؛ د لاس لیکل شوي ډیټاسیټ د نوټونو، لاسي نسخو، او سټایلس ان پټ سره سمون لري. د کلمې کچې او د کرښې کچې تشریحات د بشپړ OCR پایپ لاینونو ملاتړ کوي، پداسې حال کې چې د کرکټر کچې سیټونه د طبقه بندي اساساتو سره سمون لري. تل د جواز شرایط تایید کړئ، ځکه چې ځینې OCR ډیټاسیټ یوازې د څیړنې لپاره دي یا راجسټریشن ته اړتیا لري.
غوره سندونه او فورمې OCR ډیټاسیټونه کوم دي؟
د اسنادو OCR ډیټاسیټونه ماډلونه روزي ترڅو جوړښتي پاڼې لکه رسیدونه، فورمې، رسیدونه، او IDs تجزیه کړي. دا د سوداګرۍ اسنادو اتومات کولو او د کلیدي ارزښت استخراج ته ځواک ورکوي.
- د FUNSD — ۱۹۹ تشریح شوي سکین شوي فورمې چې شورماشور، حقیقي نړۍ بڼه لري. د فورمو د پوهیدو او د کلیدي ارزښت استخراج لپاره معیاري معیار.
- د SROIE سره — د ICDAR ۲۰۱۹ سکین شوي رسید ډیټاسیټ چې شاوخوا ۱۰۰۰ رسیدونه لري، چې په یوه سیټ کې د متن کشف، پیژندنه، او معلوماتو استخراج ملاتړ کوي.
- کارډ — د رسیدونو یو جامع ډیټاسیټ چې د OCR وروسته تحلیل لپاره جوړ شوی، د رسیدونو او رسیدونو اتومات کولو لپاره د ساحې په کچه بډایه لیبلونو سره.
- XFUND — د FUNSD څو ژبني توسیع چې اووه ژبې (جرمني، هسپانوي، فرانسوي، ایټالوي، جاپاني، پرتګالي، چینایي) پوښي چې هر یو یې ۱۹۹ پاڼې لري. د څو ژبو سند AI لپاره مثالی دی.
- د DDI-100 معرفي کول — شاوخوا ۱۰۰،۰۰۰ تحریف شوي اسناد انځورونه د حقیقي نړۍ د تخریب لکه سکیو، بلور، او شور لاندې کشف او پیژندلو لپاره.
د صحنې متن OCR ډیټاسیټونه کوم دي؟
د منظرې متن OCR ډیټاسیټونه ماډلونو ته روزنه ورکوي چې په طبیعي انځورونو لکه نښو، محصولاتو او د سړک صحنو کې متن ولولي. دا د ځنګلي OCR لپاره اړین دي چیرې چې شالیدونه ګډوډ وي.
- د ICDAR قوي لوستل — د ډیری صحنې-متن څیړنې تر شا د معیار کورنۍ، په شمول د تمرکز شوي او ناڅاپي صحنې متن د کلمې کچې محدود بکسونو او نقلونو سره ننګونې.
- د کوکو متن — د MS-COCO انځورونو باندې پرتې د لویې کچې صحنې متن تشریحات. په طبیعي صحنو کې په پیمانه د متن کشف لپاره قوي.
- ټول متن — په منحني او په خپل سري ډول متن کې تخصص لري، چې د زړو OCR ماډلونو لپاره یو پیژندل شوی کمزوری ځای دی.
- SVT (د سړک لید متن) — د ګوګل سټریټ ویو څخه راټول شوي کلمې انځورونه، ډیری وختونه ټیټ ریزولوشن او لوړ تغیرات. د کوډ عکسونو سره د کاغذونو له لارې شتون لري.
- د متن لوړه برخه — د پراګراف څخه تر کرښې پورې کلمې ته د سلسلې سلسلې تشریح، چې د لاس لیکل شوي او چاپ شوي صحنې متن دواړه پوښي. د ترتیب څخه خبر OCR لپاره ګټور.
د OCR غوره ډیجیټ او کرکټر ډیټاسیټونه کوم دي؟
د OCR ډیجیټ او کرکټر ډیټاسیټونه ماډلونو ته روزنه ورکوي چې په کنټرول شوي ترتیباتو کې انفرادي سمبولونه وپیژني. دا د ډلبندۍ اساساتو لپاره معیاري پیل ټکي دي.
- MNIST — ۷۰،۰۰۰ خړ رنګه لاس لیکل شوي عددي انځورونه. د عددي طبقه بندي د اعتبار لپاره ترټولو ګړندی اساس.
- ایمنیسټ — د NIST ځانګړي ډیټابیس ۱۹ څخه اخیستل شوي ۸۱۴،۲۵۵ لاس لیکل شوي لیکونو او عددونو سره MNIST پراخوي.
- SVHN (د سړک د لیدلو د کورونو شمیرې) — د کورونو شمېرو څخه د ۶۰۰،۰۰۰ څخه ډیر حقیقي نړۍ عددي انځورونه. د شورماشور شرایطو لپاره د MNIST څخه یو عملي ګام.
- چارس ۷۴K — ۷۴،۱۰۷ انځورونه چې د طبیعي انځورونو او کمپیوټر فونټونو څخه انګلیسي او کناډا حروف پوښي.
- د NIST ځانګړی ډیټابیس ۱۹ — د ۳،۶۰۰ لیکوالانو څخه ۸۱۰،۰۰۰+ لاس چاپ شوي کرکټر انځورونه. د انګلیسي ژبې ډیری OCR معیارونه له هغه سرچینې څخه اخیستل شوي دي.
د OCR لپاره غوره لاسي لیکلو ډیټاسیټونه کوم دي؟
د لاس لیکلو ډیټاسیټونه د OCR ماډلونو ته روزنه ورکوي چې کرسیو، چاپ شوي، او تاریخي لاس لیکل شوي متن ولولي. د لاس لیکلو قوي خلاص ډیټاسیټونه د لاس لیکل شوي متن پیژندنې (HTR) لپاره ترټولو ډیر یاد شوي معیارونه پاتې دي.
- د IAM لاسي لیکنې ډیټابیس — د انګلیسي لاس لیکلو د سرو زرو معیار، د ۶۵۷ لیکوالانو څخه ۱۳،۳۵۳ متني کرښې. لاهم د ۲۰۲۴-۲۰۲۵ OCR څیړنې کې ترټولو ډیر حواله شوی لاس لیکلو ډیټاسیټ دی.
- IAM-OnDB — د IAM آنلاین قلم-سټروک نسخه، د ټراژېکټوري ډیټا نیول. د سټایلس او ټابلیټ پیژندنې لپاره د لاس لیکلو کینونیکي ډیټاسیټ.
- د بینټم کاغذونه — د فیلسوف جیریمي بینټم څخه لیکل شوي تاریخي انګلیسي لاسوندونه. د تاریخي لاسوند OCR لپاره مخکښ معیار، د ټرانسکریبس له لارې د لاسرسي وړ.
- GNHK (د ښه نوټونو د لاس لیکلو ټولګه) — د ۲۰۲۱ کال د انګلیسي ژبې د لاس لیکل شویو غیر محدودو معلوماتو ډیټاسیټ. د لابراتوار پاک IAM په پرتله د تولید ګډوډ معلوماتو ته نږدې.
غوره څو ژبني او غیر لاتیني OCR ډیټاسیټونه کوم دي؟
د څو ژبو OCR ډیټاسیټونه د انګلیسي ژبې هاخوا د سکریپټونو په اړه ماډلونه روزي، په شمول د چینایي، عربي، او ریاضيکي نوټیشن. دا د نړیوال سند او لاس لیکلو پیژندنې لپاره اړین دي.
- کاسیا-ایچ ډبلیو ډي بي — د چینایي معیاري OCR معیار، د 1,020 لیکوالانو څخه د 1.17 ملیون لاس لیکل شوي کرکټر نمونو سره.
- خټ — د ۱۰۰۰ مختلفو لیکوالانو څخه ۱۰۰۰ عربي لاس لیکل شوي فورمې، په څو ریزولوشنونو کې سکین شوي. تر ټولو جامع خلاص عربي OCR ډیټاسیټ.
- کروم — د آنلاین لاس لیکل شوي ریاضيکي عبارتونو د پیژندنې په اړه سیالي: په آنلاین او آفلاین ډولونو کې د 101+ ریاضي سمبولونو په اوږدو کې 10,000+ عبارتونه. د لاس لیکل شوي معادلې OCR لپاره اړین دی.
د وړیا OCR ډیټاسیټونو کارولو پرمهال عام زیانونه کوم دي؟
درې خطرونه ډیری ټیمونه نیسي.
د ډومین نا مطابقت: د پاک IAM یا COCO-Text په اړه روزنه او په ماتو شویو رسیدونو کې ځای پرځای کول د ضعیف دقت تضمین کوي.
د جواز ړانده والی: ډیری صحنې متن او تاریخي OCR ډیټاسیټونه یوازې د څیړنې لپاره دي یا د سوداګریزې کارونې دمخه راجسټریشن ته اړتیا لري.
د تشریح تشې: ډیری OCR ډیټاسیټونه د ترتیب میټاډاټا، د کرښې کچې محدود بکسونه، یا د ساحې لیبلونه نلري چې د تولید سیسټمونه ورته اړتیا لري.
د منځنۍ اندازې لوژستیکي شرکت تصور وکړئ چې د بار وړلو لیبل لوستل اتومات کوي. د عامه صحنې متن روزنه دوی په معیارونو کې 80٪ ته رسوي، مګر د ځلا او پوښونو سره اصلي لیبلونه دوی 58٪ ته راټیټوي. د دې تشې د بندولو لپاره د پیل کولو دمخه د 6,000 دننه ډومین لیبل عکسونو هدفمند ډیټا تشریح ته اړتیا وه.
د خلاصې سرچینې ډیټا سیټونو ګټې او ننګونې
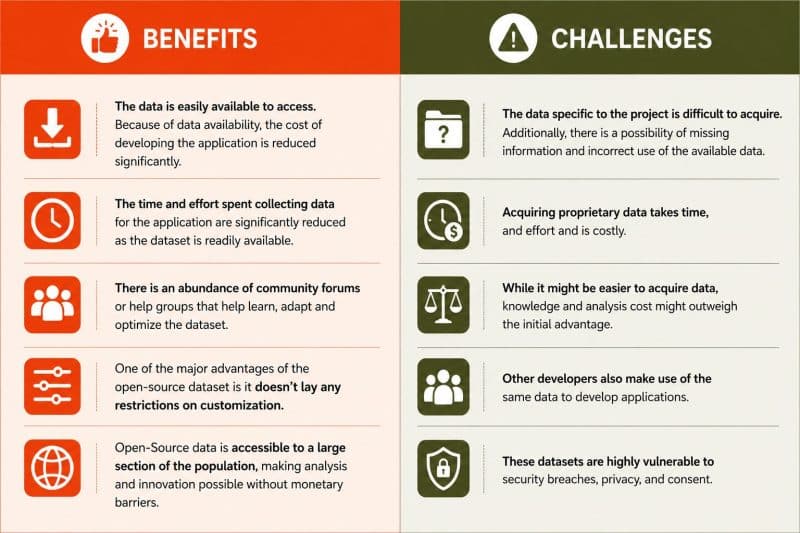
سوداګرۍ باید د یو بل په وړاندې ګټې او ننګونې ودروي ترڅو پوه شي چې ایا دوی باید د دوی د ML غوښتنلیکونو لپاره وړیا کارولو ډیټا غوره کړي.
ګټې
- معلوماتو ته د لاسرسي لپاره په اسانۍ سره شتون لري. د معلوماتو د شتون له امله، د غوښتنلیک د پراختیا لګښت د پام وړ کم شوی.
- د غوښتنلیک لپاره د معلوماتو راټولولو وخت او هڅې د پام وړ کم شوي ځکه چې ډیټاسیټ په اسانۍ سره شتون لري.
- دلته د ټولنې فورمونو یا د مرستې ګروپونو کثرت شتون لري چې د ډیټاسیټ زده کړې ، تطبیق او اصلاح کولو کې مرسته کوي.
- د خلاصې سرچینې ډیټاسیټ یوه لویه ګټه دا ده چې دا په تخصیص باندې هیڅ محدودیت نلري.
- د خلاصې سرچینې ډیټا د نفوس یوې لویې برخې ته د لاسرسي وړ دي ، پرته له پیسو خنډونو تحلیل او نوښت ممکن کوي.
ننګونې
- د پروژې لپاره مشخص معلومات ترلاسه کول ستونزمن دي. سربیره پردې، د معلوماتو د ورکیدو او د شته معلوماتو د ناسم استعمال احتمال شته.
- د ملکیت معلوماتو ترلاسه کول وخت، هڅې او لګښت لري
- پداسې حال کې چې دا ممکن د معلوماتو ترلاسه کول اسانه وي، د پوهې او تحلیل لګښت ممکن د ابتدايي ګټې څخه ډیر وي.
- نور پراختیا کونکي هم د غوښتنلیکونو پراختیا لپاره ورته ډیټا کاروي.
- دا ډیټاسیټونه د امنیت سرغړونو ، محرمیت او رضایت لپاره خورا زیان منونکي دي.
شایپ څنګه د OCR او لاس لیکلو پیژندنې پروژو ملاتړ کوي؟
د شایپ د OCR روزنیزو معلوماتو خدمتونه د خلاص ډیټا سیټ کیوریشن د 60+ ژبو کې د دودیز معلوماتو راټولولو سره یوځای کوي ، چې چاپ شوي اسناد، لاس لیکل، رسیدونه، او IDs پکې شامل دي. د شایپ د تشریح کاري جریان هغه پرتونه اضافه کوي چې عامه OCR ډیټا سیټونه یې له لاسه ورکوي: د کرښې کچې محدودیت بکسونه، د ساحې کچې لیبلونه، د لیږد QC، او د لیکوال میټاډاټا.
پایله
پورته ۲۲ OCR ډیټاسیټونه تاسو ته د ۲۰۲۶ کال لپاره د سند، صحنې متن، عدد، لاس لیکلو او څو ژبو پیژندنې لپاره بشپړ خلاصې سرچینې بنسټ درکوي. د OCR ډیټاسی سره پیل وکړئ چې ستاسو د متن ډول او کیپچر چاپیریال سره سمون خوري، ستاسو د اصلي معلوماتو د ساتل شوي نمونې په وړاندې تایید کړئ، او د ډومین تشې د بندولو لپاره د دودیز تشریح لپاره بودیجه ورکړئ. دا ترکیب د پیل څخه د جوړولو په پرتله ګړندی راځي.